
OpenAI breidt de Library in ChatGPT uit met directe samenwerking. Gebruikers kunnen voortaan bestanden en volledige mappen delen met specifieke personen of binnen hun workspace, daarbij Viewer- of Editorrechten instellen en gedeelde inhoud rechtstreeks gebruiken in gesprekken met ChatGPT. De stap maakt van de Library minder een persoonlijk archief en meer een centrale werklaag voor documenten, analyses en terugkerende projecten. Waar de Library tot nu toe vooral diende om eerder geüploade en aangemaakte bestanden terug te vinden en opnieuw te gebruiken, kunnen gebruikers bestanden en mappen nu ook rechtstreeks delen met anderen. Gedeelde bestanden verschijnen bij ontvangers onder ‘Shared with me’ en kunnen vervolgens rechtstreeks als bron in nieuwe gesprekken met ChatGPT worden gebruikt.
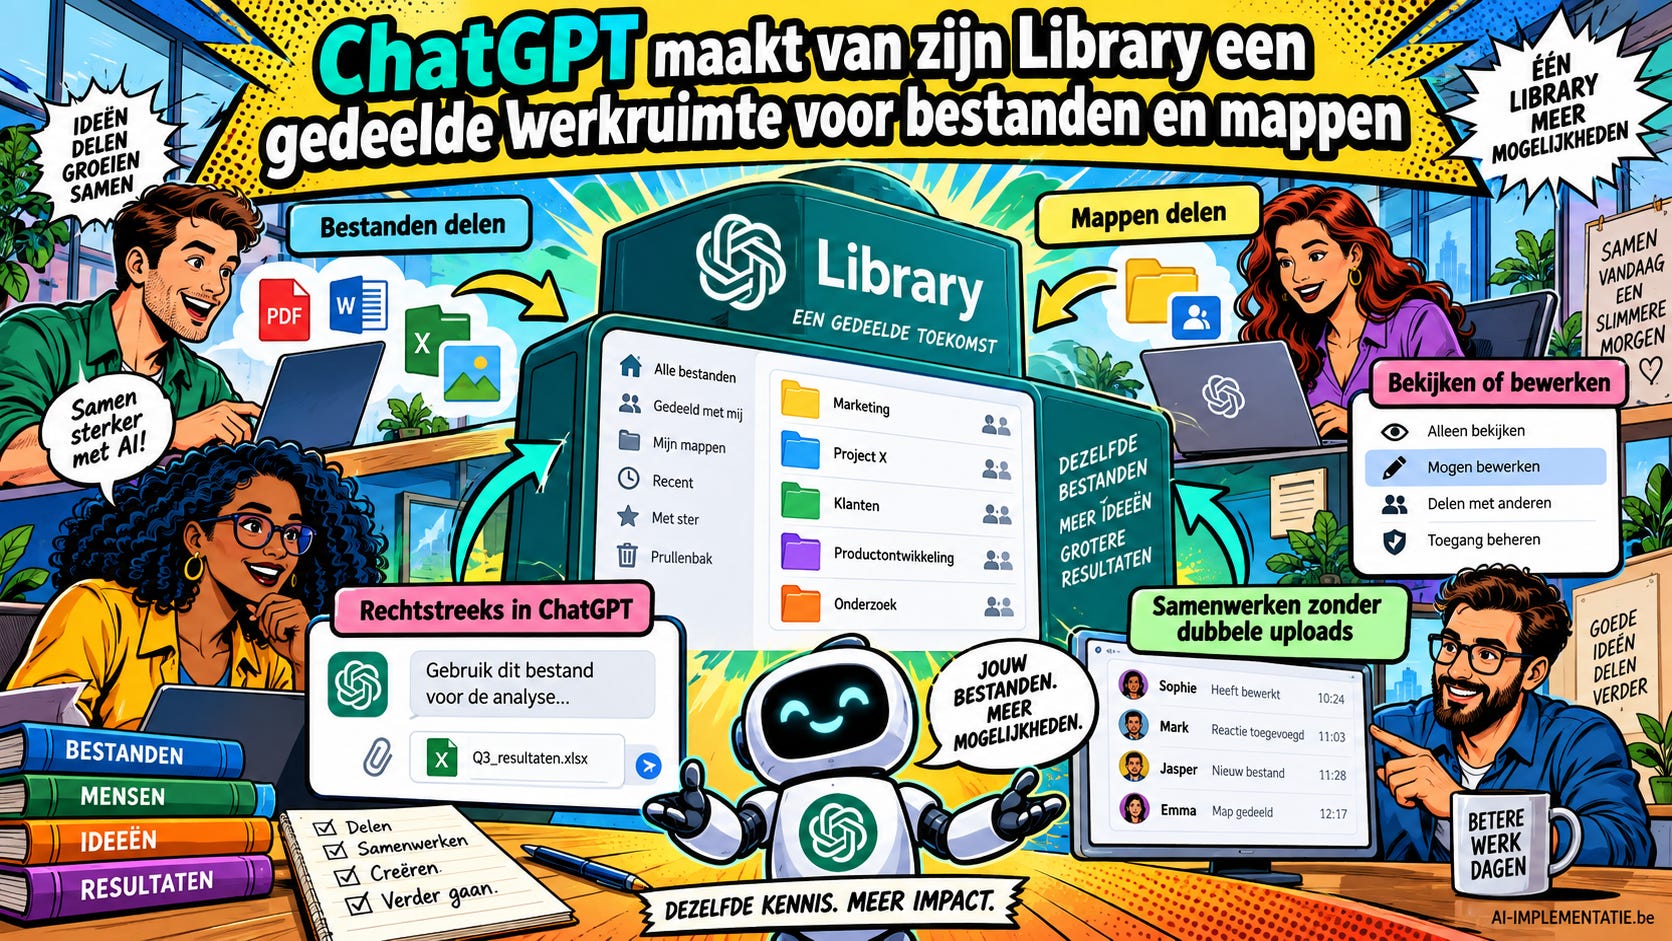
Voor de voorbereidingen van de inhoud en creatie van de visuals wordt (uiteraard) gebruikgemaakt van generatieve AI.
Van persoonlijk archief naar gedeelde kennislaag
De verandering lijkt op het eerste gezicht klein, maar ze verschuift de rol van de Library aanzienlijk.
Bestanden die gebruikers uploaden of in ChatGPT creëren, worden automatisch opgeslagen in de Library. Vanuit daar kunnen ze later opnieuw aan een gesprek worden toegevoegd zonder opnieuw te moeten worden geüpload. Ook volledige mappen kunnen worden geselecteerd zodat ChatGPT over meerdere bestanden tegelijk kan werken.
Met sharing wordt dat mechanisme nu bruikbaar voor teams. Een projectgroep kan bijvoorbeeld een gedeelde map gebruiken voor rapporten, briefingdocumenten, analyses en bronmateriaal. Iedereen met toegang kan vervolgens vanuit zijn eigen gesprek met dezelfde inhoud werken.
Dat voorkomt een klassiek probleem bij AI-gebruik in teams: verschillende mensen uploaden telkens hun eigen kopieën van documenten, waarna meerdere versies naast elkaar beginnen te bestaan.
Viewer en Editor geven verschillende rollen
Bij het delen kunnen gebruikers specifieke personen uitnodigen of, waar beschikbaar, materiaal toegankelijk maken voor de volledige workspace. Toegang kan later opnieuw worden bekeken, aangepast of ingetrokken.
Een interessant detail zit bij gedeelde mappen. Bestanden die iemand uploadt naar de gedeelde map van een andere eigenaar, worden onderdeel van die map. Wanneer de uploader later zijn toegang tot de map verliest, blijft het bestand bij de eigenaar aanwezig en verliest de oorspronkelijke uploader zelf de toegang.
Voor organisaties betekent dit dat eigenaarschap en toegangsbeheer belangrijker worden. Een gedeelde AI-werkruimte is immers niet alleen handig voor samenwerking, maar kan ook bedrijfsinformatie bevatten die na verloop van tijd andere toegangsrechten nodig heeft.
Ook externe opslag schuift de Library binnen
De update staat niet op zichzelf. OpenAI heeft de Library de voorbije weken breder uitgebouwd. Google Drive werd eerder geïntegreerd, en vanaf 10 september volgen ook Box, Dropbox en SharePoint. Gebruikers kunnen bestanden uit die diensten vanuit ChatGPT Library vinden en in gesprekken gebruiken zonder ze eerst los te downloaden en opnieuw te uploaden.
Daarbij blijven bestaande rechten uit de brondienst gelden. Een koppeling met SharePoint of Google Drive geeft dus niet automatisch toegang tot bestanden waarvoor iemand in die omgeving geen toestemming heeft.
Interessant voor langdurige AI-projecten
De grootste praktische winst zit waarschijnlijk bij projecten die weken of maanden lopen.
In plaats van telkens opnieuw context aan ChatGPT te geven, kan een team werken vanuit één gedeelde verzameling bronbestanden. Nieuwe analyses, samenvattingen of documenten kunnen daardoor vertrekken vanuit dezelfde informatiebasis.
Dat maakt de Library steeds minder een opslagplaats naast ChatGPT en steeds meer een gedeelde contextlaag voor AI-werk.
De echte verandering zit dus niet in het delen zelf, maar in wat er daarna mogelijk wordt: meerdere mensen kunnen voortaan met dezelfde bronbestanden werken, terwijl ChatGPT die gedeelde informatie rechtstreeks in hun individuele gesprekken kan gebruiken.