
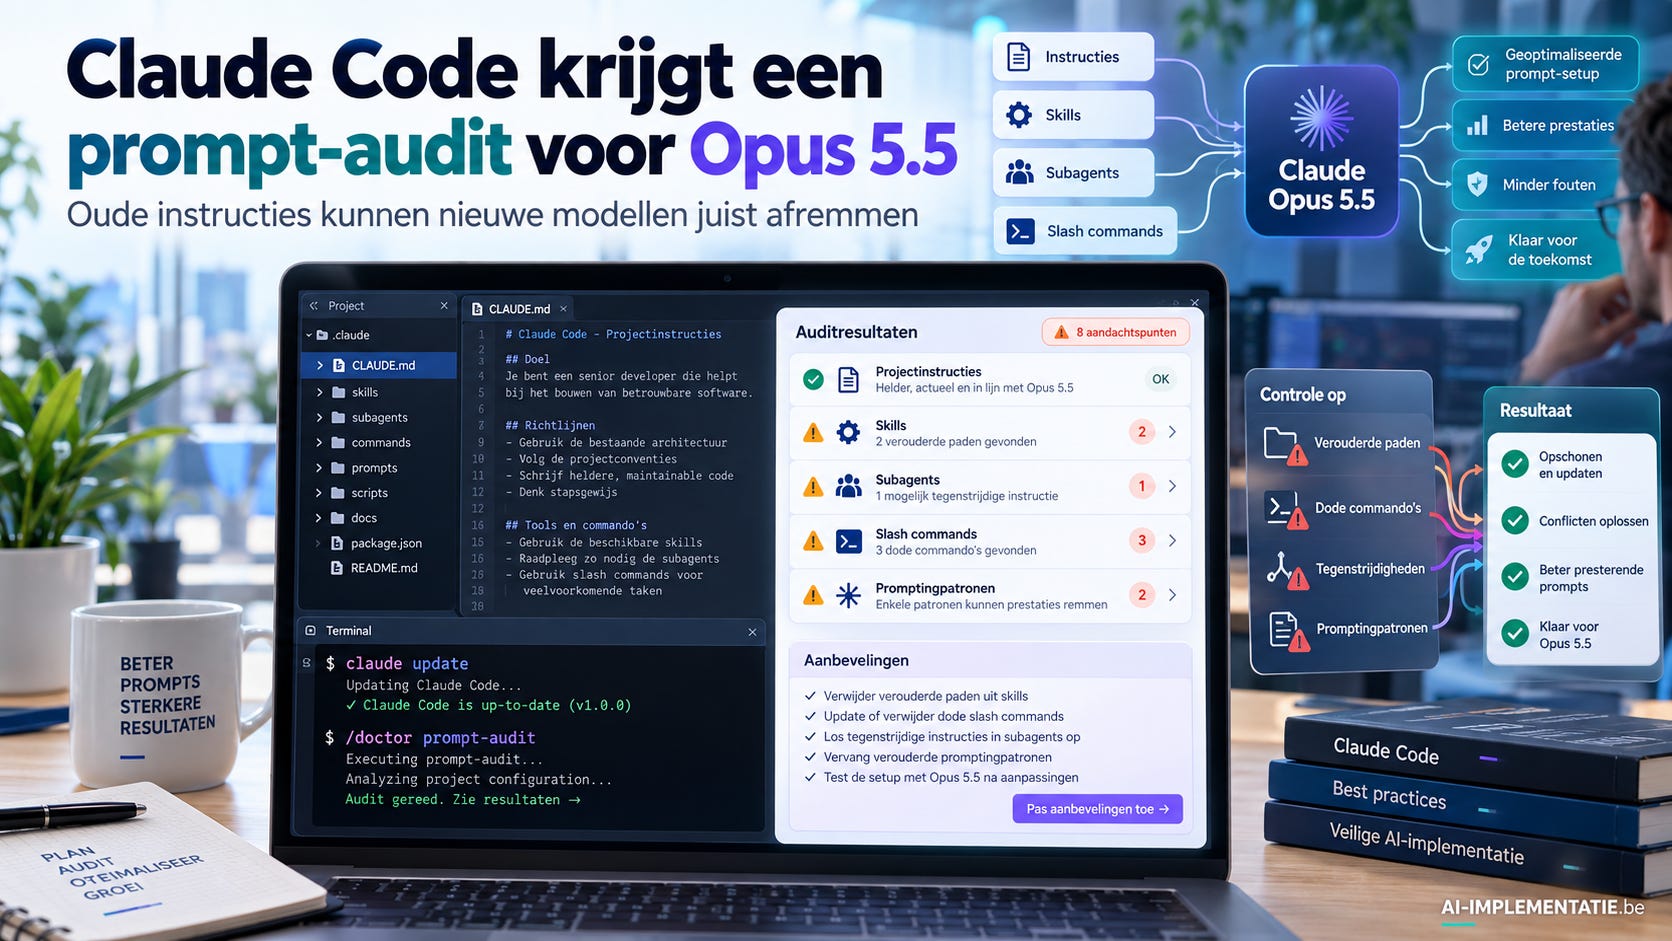
Wie Claude Code al langer gebruikt, heeft waarschijnlijk een verzameling `CLAUDE.md`-bestanden, skills, agents en slash commands opgebouwd. Met Opus 5.5 kunnen sommige van die oude instructies echter contraproductief worden. Claude Code 2.1.283 bevat daarom een nieuwe `prompt-audit` die projecten controleert op verouderde promptingpatronen, tegenstrijdigheden en configuraties die ooit nuttig waren voor oudere modellen, maar vandaag kwaliteit, snelheid of efficiëntie kunnen verminderen.
Voor de voorbereidingen van de inhoud en creatie van de visuals wordt (uiteraard) gebruikgemaakt van generatieve AI.
Nieuwe modellen, oude instructies
Bij de overstap naar een nieuw AI-model kijken ontwikkelaars doorgaans naar benchmarks, contextvensters en kosten. Minder aandacht gaat naar iets veel eenvoudigers: de instructies die ze door de jaren heen rond het model hebben gebouwd.
Een `CLAUDE.md` kan bijvoorbeeld regels bevatten als “think step by step”, extra controles opleggen of dezelfde opdracht op verschillende plaatsen herhalen. Zulke maatregelen ontstonden vaak als oplossing voor beperkingen van eerdere modelgeneraties.
Met Claude Opus 5.5 kunnen sommige van die optimalisaties juist averechts werken.
Anthropic schrijft in zijn eigen auditdocumentatie dat moderne Claude-modellen instructies nauwkeuriger en letterlijker volgen. Verouderde prompts zijn daardoor niet alleen overbodige tokens: sommige kunnen leiden tot te veel planning, overmatig toolgebruik, rigide antwoorden of conflicterende instructies.
`/doctor prompt-audit` controleert je project
Sinds Claude Code 2.1.283 is daar een specifiek hulpmiddel voor beschikbaar. Eerst is het verstandig om Claude Code zelf bij te werken:
claude updateDaarna open je Claude Code in het project dat je wilt controleren. Dat is belangrijk, omdat de audit de configuratie van dat specifieke project analyseert.
Vervolgens voer je uit:
/doctor prompt-auditDe functie controleert onder meer `CLAUDE.md`-bestanden, skills, subagents en slash commands op promptingpatronen en configuraties die voor oudere modellen werden geschreven.
Daarbij kan de audit onder meer zoeken naar:
- verouderde bestandspaden
- commando’s die niet langer werken
- tegenstrijdige instructies
- dubbele of overbodige aanwijzingen
- promptingpatronen die specifiek bedoeld waren om beperkingen van oudere modellen te compenseren.
Het equivalente commando `/checkup prompt-audit` is eveneens beschikbaar.
Daarnaast bestaat Anthropic’s uitgebreidere Claude API-audit via:
/claude-api prompt-auditDie audit onderzoekt niet alleen prompts en skills, maar kan ook toolbeschrijvingen en code analyseren waarmee API-verzoeken worden opgebouwd.
Anthropic beschrijft daarbij expliciet twee mogelijke outputs: een auditrapport en een voorgestelde diff. Het uitgangspunt is dus niet dat Claude automatisch alles herschrijft, maar dat ontwikkelaars eerst kunnen bekijken welke wijzigingen worden aanbevolen.
Niet zomaar alles verwijderen
Dat laatste is belangrijk, want een prompt-audit is geen wedstrijd om `CLAUDE.md` zo kort mogelijk te maken.Anthropic maakt juist onderscheid tussen verouderde promptingtrucs en informatie die het model onmogelijk zelf kan kennen.
Projectspecifieke architectuur, kwaliteitsvereisten, bedrijfsregels, toolafspraken, beveiligingsrichtlijnen en andere projectcontext kunnen nog altijd essentieel zijn. Een regel als: “Gebruik voor databasewijzigingen altijd deze migratieworkflow” kan bijvoorbeeld perfect relevant blijven.
Een instructie als: “Denk eerst uitgebreid stap voor stap na voordat je een antwoord geeft” kan bij een nieuwer model veel minder nuttig zijn wanneer dat model zijn redeneerproces al standaard op een andere manier organiseert. Het doel van de audit is daarom niet om zoveel mogelijk instructies te verwijderen, maar om te ontdekken welke regels nog daadwerkelijk waarde toevoegen.
Test eerst wat de audit markeert
AI-ontwikkelaar Dan McAteer, die de nieuwe audit onder de aandacht bracht, geeft daarbij een praktische waarschuwing: verwijder niet blind alles wat wordt gemarkeerd.
Wanneer de audit bijvoorbeeld zegt dat een bepaald commando niet meer werkt, is het verstandig om dat commando eerst zelf uit te voeren. Werkt het inderdaad niet meer, dan kan de configuratie worden aangepast.
Werkt het nog wel, dan kan er een reden zijn om de instructie te behouden.
Die aanpak is belangrijk omdat ontwikkelomgevingen sterk van elkaar verschillen. Sommige teams hebben aangepaste scripts, interne tools of specifieke conventies die een algemene audit niet volledig kan begrijpen. De tool moet daarom vooral worden gezien als een reviewmechanisme, niet als een automatische schoonmaakrobot.
Waarom oude prompts nieuwe modellen kunnen hinderen
De ontwikkeling van AI-codingtools gaat momenteel zo snel dat promptconfiguraties verrassend snel kunnen verouderen.
Teams bouwden de afgelopen jaren allerlei technieken in om modellen betrouwbaarder te maken. Ze instrueerden een model bijvoorbeeld om: altijd eerst een uitvoerig plan te schrijven, bepaalde tools alleen via specifieke omwegen te gebruiken of expliciet te blijven doorwerken tot alle subtaken waren voltooid.
Voor een ouder model konden zulke instructies nuttig zijn. Maar wanneer een nieuw model zelfstandiger kan plannen, tools betrouwbaarder gebruikt en instructies letterlijker opvolgt, kunnen dezelfde regels ineens dubbel werk veroorzaken.
Het model kan dan te lang plannen, onnodig veel toolcalls uitvoeren of zichzelf vastzetten in procedures die oorspronkelijk bedoeld waren om zwakkere modellen te corrigeren.
Opus 5.5 vraagt een andere manier van werken
Anthropic publiceerde ook nieuwe richtlijnen voor Opus 5.5. Daarin adviseert het bedrijf onder meer om opdrachten duidelijk te definiëren en expliciet te beschrijven wanneer een taak als afgerond geldt.
Generieke aansporingen zoals “think carefully” zijn volgens die richtlijnen meestal minder noodzakelijk, omdat Opus 5.5 standaard voor ieder antwoord redeneert. Daarmee verschuift de focus van prompting. In plaats van het model voortdurend te vertellen ‘hoe hard het moet nadenken’, wordt het belangrijker om duidelijk te maken:
- wat het gewenste eindresultaat is
- welke beperkingen gelden
- welke acties zelfstandig mogen worden uitgevoerd
- wanneer menselijke toestemming nodig is
- wanneer het werk als voltooid mag worden beschouwd.
Dat geldt zeker voor Claude Code, waar een model niet alleen tekst genereert, maar ook bestanden kan aanpassen, opdrachten kan uitvoeren en langere ontwikkeltaken zelfstandig kan afwerken.
Langdurige agents maken goede instructies belangrijker
Sterkere modellen betekenen bovendien niet dat configuratie minder belangrijk wordt. Het tegenovergestelde kan zelfs waar zijn. Wanneer een codingagent maar één klein commando uitvoert, heeft een slechte instructie beperkte gevolgen.
Wanneer een agent twintig minuten zelfstandig code analyseert, bestanden wijzigt, tests uitvoert en problemen probeert op te lossen, kan een foutieve regel veel langer doorwerken.
Daarom worden instructies rond bijvoorbeeld destructieve handelingen, toestemming, scope en stopvoorwaarden belangrijker. Een regel die bepaalt wanneer een agent moet stoppen en de gebruiker opnieuw om goedkeuring moet vragen, kan waardevoller zijn dan tien oude prompts die het model aansporen om nog eens extra goed na te denken.
Promptbeheer wordt onderdeel van modelmigratie
De bredere les gaat verder dan Claude Code. AI-instructies zijn steeds minder iets wat ontwikkelaars één keer schrijven en daarna vergeten. `CLAUDE.md`-bestanden, system prompts, skills, agents en custom commands vormen samen steeds vaker een soort softwarelaag boven op het model.
En net zoals gewone software onderhoud nodig heeft, moeten ook die instructies opnieuw worden bekeken wanneer het onderliggende model verandert. Een prompt die voor een oudere modelgeneratie noodzakelijk was, kan bij een capabeler model overbodig worden. Een workaround kan veranderen in ruis. Een veiligheidsregel kan nog altijd cruciaal zijn. En een uitgebreid stappenplan kan worden vervangen door één duidelijke beschrijving van het gewenste resultaat.
Voor teams die intensief met Claude Code werken, wordt een modelupgrade daardoor ook een configuratie-audit. Niet alleen controleren wat het nieuwe model kan, maar vooral nagaan welke oude instructies het inmiddels niet meer nodig heeft. De nieuwe `prompt-audit` maakt dat proces expliciet.
En dat is misschien wel de belangrijkste boodschap achter de functie: wie zijn AI-model vernieuwt, moet ook de prompts eromheen durven vernieuwen.