
Google heeft Gemini 3.8 Live en Gemini 3.8 Live Extended Thinking uitgebracht, twee nieuwe audio-to-audio-modellen voor realtime spraaktoepassingen. Ze combineren luisteren, redeneren, spreken en het uitvoeren van tools binnen één live model, waardoor ontwikkelaars minder losse componenten hoeven te koppelen. De modellen ondersteunen gesprekken in 97 talen, kunnen visuele informatie verwerken en laten achtergrondtaken doorlopen zonder het gesprek stil te leggen. De Extended Thinking-versie voegt daar zwaarder redeneren voor complexere workflows aan toe.
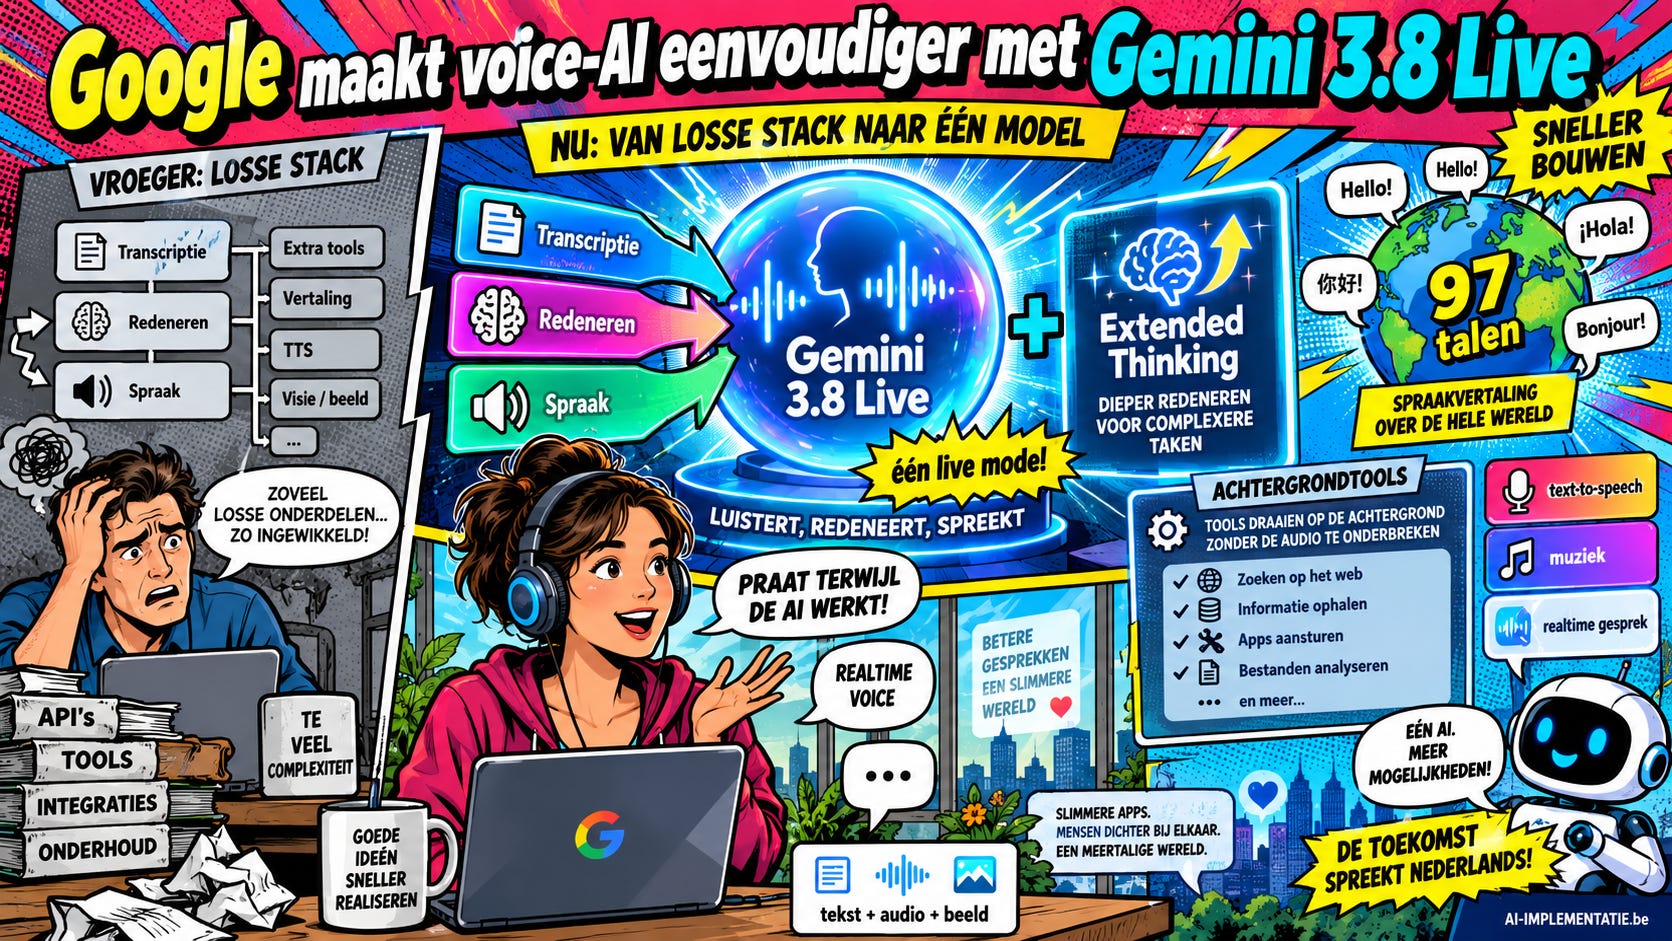
Voor de voorbereidingen van de inhoud en creatie van de visuals wordt (uiteraard) gebruikgemaakt van generatieve AI.
Praten terwijl de AI ondertussen werkt
Google zet met Gemini 3.8 Live een duidelijke stap richting voice-agents die minder aanvoelen als een verzameling losse AI-diensten. Traditionele spraakapplicaties bestaan vaak uit verschillende onderdelen: automatische spraakherkenning zet audio om in tekst, een taalmodel verwerkt die tekst en een afzonderlijk text-to-speechmodel spreekt het antwoord vervolgens uit.
Gemini 3.8 Live werkt rechtstreeks als audio-to-audio-model. Het ontvangt onder meer tekst, beeld, audio en video en kan zelf tekst en audio produceren. Daardoor kunnen ontwikkelaars een groot deel van die klassieke keten vervangen door één live interactiemodel. Een van de opvallendste verbeteringen is de manier waarop het model externe tools kan gebruiken.
Gemini 3.8 Live ondersteunt asynchrone functieaanroepen. Een voice-agent kan bijvoorbeeld informatie uit een achterliggend systeem ophalen terwijl het gesprek met de gebruiker gewoon doorgaat. Het model hoeft dus niet noodzakelijk stil te vallen terwijl een API, database of bedrijfsapplicatie een antwoord voorbereidt.
Dat klinkt technisch, maar het verschil is belangrijk voor de gebruikerservaring. Denk aan een telefonische assistent die tijdens het gesprek een reservatie controleert, een bestelling opzoekt of bedrijfsinformatie raadpleegt. In plaats van een lange stilte kan de AI de gebruiker blijven begeleiden en het resultaat verwerken zodra de achtergrondtaak klaar is.
Google ondersteunt bovendien automatische taalwissels binnen gesprekken. Volgens het bedrijf kan Gemini 3.8 Live tussen 97 ondersteunde talen schakelen zonder dat de ontwikkelaar telkens expliciet een nieuwe taal hoeft te selecteren.
Extended Thinking voor moeilijkere taken
Naast het reguliere model introduceert Google Gemini 3.8 Live Extended Thinking.
Die variant is bedoeld voor situaties waarin een spraakagent complexere problemen moet oplossen. Het model kan op de achtergrond uitgebreider redeneren terwijl de audio-interactie blijft doorlopen. Google positioneert het bijvoorbeeld voor meerstapsprocessen waarbij verschillende acties, gegevensbronnen of beslissingen gecombineerd moeten worden.
Het verschil tussen beide modellen is daarmee vooral praktisch. Gemini 3.8 Live richt zich op lage latency en schaalbare realtime gesprekken. Extended Thinking offert meer rekenwerk op aan diepere analyse wanneer een taak daar om vraagt.
Beide modellen hebben een contextlimiet van 131.072 inputtokens en ondersteunen functieaanroepen en Google Search-grounding. De Extended Thinking-versie ondersteunt daarbij expliciet achtergrondredenering en uitsluitend asynchrone function calling.
Ook beeld wordt onderdeel van het gesprek
Voice betekent bij Google inmiddels niet langer alleen audio. Gemini 3.8 Live kan tijdens een gesprek ook visuele informatie verwerken. Een gebruiker kan bijvoorbeeld een camerabeeld of andere visuele input aanbieden, waarna de AI die context mee kan nemen in zijn gesproken antwoord. Google spreekt daarbij van near-realtime visual grounding.
Daarmee schuift het concept van een voice-agent op richting een multimodale assistent die tegelijkertijd kan luisteren, kijken, redeneren en handelen.
Niet alles zit letterlijk in hetzelfde model
De aankondiging wordt soms voorgesteld alsof Google met Gemini 3.8 Live meteen zijn volledige spraakstack heeft samengevoegd. Dat vraagt enige nuance.
Binnen de bredere Gemini API biedt Google daarnaast afzonderlijke modellen voor onder meer realtime spraakvertaling en text-to-speech. Gemini 3.5 Live Translate is bijvoorbeeld een apart model voor realtime speech-to-speechvertaling in meer dan 70 talen. Muziekgeneratie behoort eveneens tot Google’s bredere generatieve AI-aanbod, maar is geen ingebouwde functie van Gemini 3.8 Live zelf.
De echte vernieuwing zit dus niet in één universeel model dat iedere audiofunctie vervangt, maar in het feit dat het centrale gesprekssysteem veel meer werk zelf kan uitvoeren.
Voice-agents worden een stuk makkelijker te bouwen
Voor ontwikkelaars is dat waarschijnlijk de belangrijkste verandering. Minder losse stappen betekent minder synchronisatie tussen transcriptie, redenering, toolgebruik en spraakuitvoer. Tegelijk kan de agent tijdens een gesprek blijven werken, externe systemen aanspreken en visuele context gebruiken.
Gemini 3.8 Live en Gemini 3.8 Live Extended Thinking zijn sinds half september 2026 beschikbaar via de Gemini API en Google AI Studio. Google rolt de technologie daarnaast uit naar onder meer Gemini Live, Search en zakelijke toepassingen.
De richting is duidelijk: de voice-agent evolueert van een keten van afzonderlijke AI-componenten naar één continu, multimodaal systeem dat luistert, redeneert, spreekt en ondertussen taken uitvoert.