
TypeSafe AI introduceert Jev, een nieuw modeltype dat niet is gebouwd om tekst te schrijven of gesprekken te voeren, maar om razendsnel gestructureerde beslissingen te nemen binnen software. De startup van voormalig OpenAI-onderzoeker Diogo Almeida noemt dit een “System One Model”: ongestructureerde data gaan erin, getypeerde beslissingen met kansen en confidence-scores komen eruit. TypeSafe claimt veel lagere kosten en veel kortere responstijden dan klassieke LLM’s, maar erkent tegelijk dat Jev nog foutieve beslissingen kan nemen en dat de eerste benchmarks beperkingen hebben.
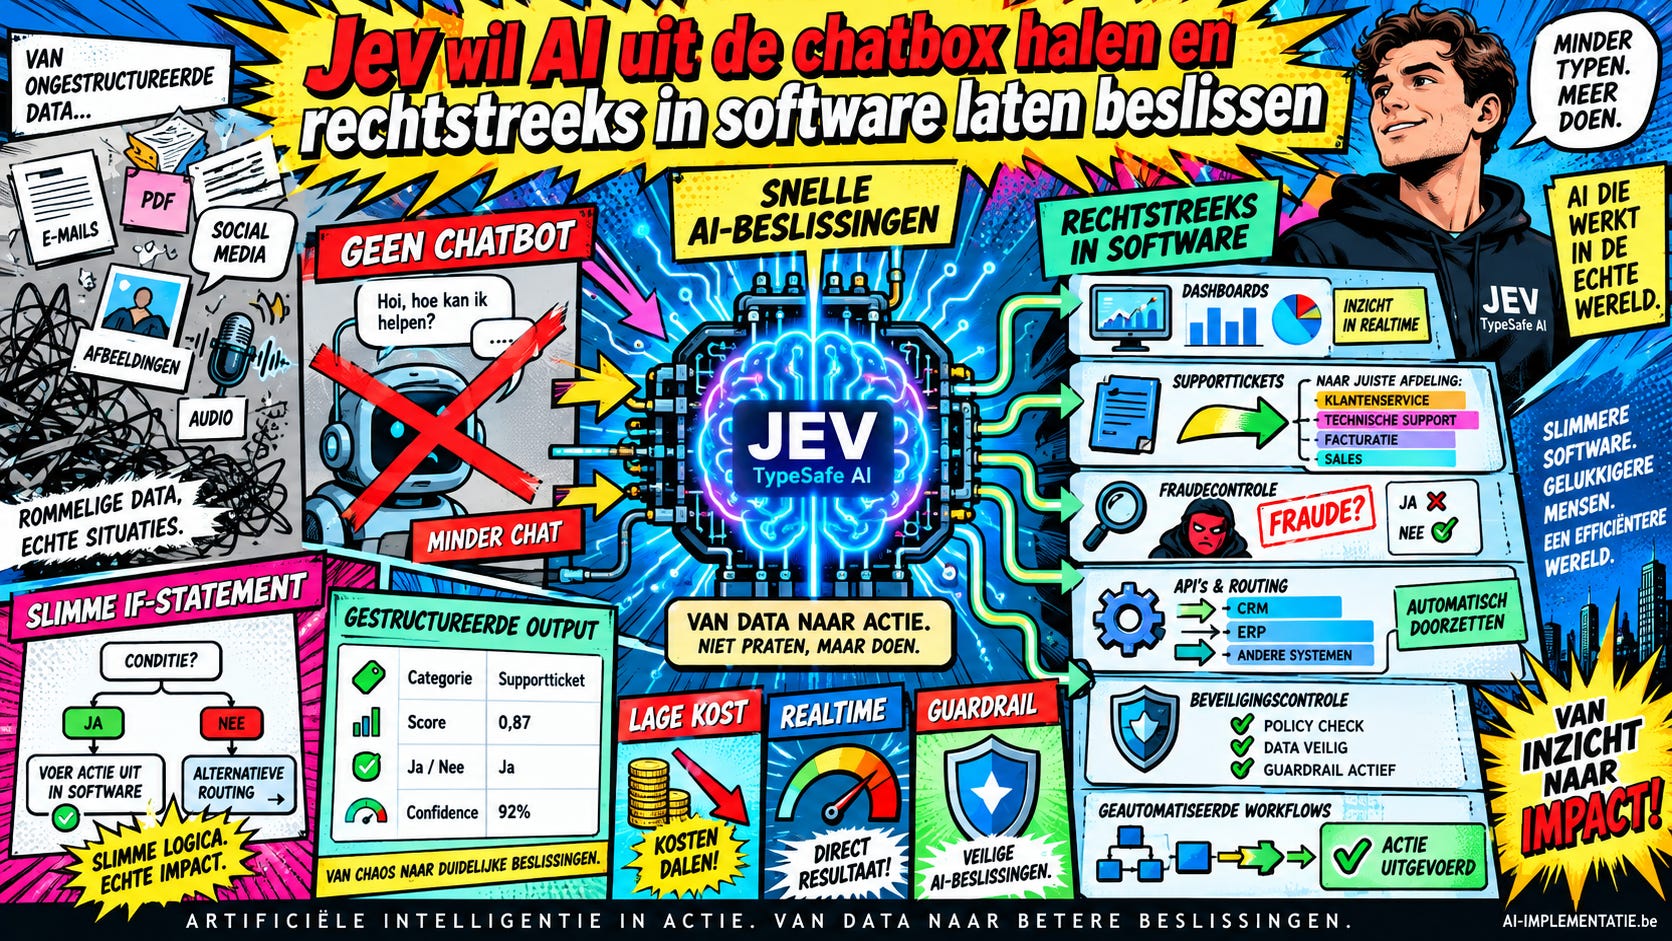
Voor de voorbereidingen van de inhoud en creatie van de visuals wordt (uiteraard) gebruikgemaakt van generatieve AI.
TypeSafe AI wil de omweg schrappen.
De meeste AI-systemen van vandaag zijn gebouwd rond één fundamenteel idee: tekst genereren. Zelfs wanneer een bedrijf een model gebruikt om een simpele beslissing te nemen, bijvoorbeeld “is deze aanvraag fraude?”, “naar welk team moet dit ticket?” of “moet deze AI-output worden geblokkeerd?”, produceert een klassiek taalmodel doorgaans eerst tekst die daarna opnieuw door software moet worden geïnterpreteerd.
Na twee jaar in stealth lanceert het bedrijf Jev, het eerste model in wat het zelf een nieuwe categorie noemt: System One Models. De naam verwijst naar het concept van snelle, intuïtieve beslissingen uit Daniel Kahnemans Thinking, Fast and Slow. In plaats van lange antwoorden te genereren, is Jev ontworpen als een soort intelligente beslisfunctie die rechtstreeks in software kan worden ingebouwd.
Geen chatbot, maar een beslismotor
Jev verschilt fundamenteel van een gewone LLM. De software stuurt een stuk ongestructureerde informatie naar het model, bijvoorbeeld de inhoud van een supportticket, een transactie, een veiligheidsmelding of de output van een AI-agent, samen met vooraf gedefinieerde vragen.
Jev retourneert vervolgens alleen waarden binnen de toegestane structuur. Het model kan onder meer:
- een keuze maken uit vooraf bepaalde opties;
- een score geven op een gedefinieerde schaal;
- een ja/nee-beslissing teruggeven met waarschijnlijkheden;
- confidence-scores leveren waarmee software kan bepalen hoe zeker het model van zijn beslissing is.
Het resultaat is dus geen alinea tekst die opnieuw geparsed moet worden, maar een getypeerde output die software onmiddellijk kan gebruiken.
Dat lijkt op het eerste gezicht een beperking. Jev kan geen e-mail schrijven, geen code genereren en geen gesprek voeren. Maar precies door die vrijheid op te geven, zegt TypeSafe veel efficiënter te kunnen werken.
Alle beslissingen tegelijk in plaats van woord voor woord
Klassieke taalmodellen zijn autoregressief: ze genereren het ene token na het andere. Elk volgend woord hangt af van wat daarvoor werd geproduceerd. Jev gebruikt volgens TypeSafe een andere architectuur waarbij antwoorden parallel worden gegenereerd.
Wanneer software bijvoorbeeld twintig eigenschappen van een document wil beoordelen, hoeft het model niet twintig antwoorden woord voor woord uit te schrijven. De beslissingen kunnen in één query worden berekend.
TypeSafe combineert dat met een eigen trainingsmethode: Reinforcement Learning for Calibrated Decisions, of RLCD.
Het doel daarvan is niet om antwoorden te produceren die menselijke beoordelaars mooi, nuttig of overtuigend vinden, maar om kansen te genereren die zo goed mogelijk overeenkomen met de daadwerkelijke kans dat een beslissing correct is.
Dat verschil is belangrijk voor automatisering. Een model dat zegt “95 procent zeker” maar slechts 70 procent van de tijd gelijk heeft, is moeilijk veilig in software te gebruiken. Een goed gekalibreerd model moet ervoor zorgen dat beslissingen waaraan het bijvoorbeeld 95 procent zekerheid toekent ook ongeveer 95 procent van de tijd correct blijken.
Daarmee kan een ontwikkelaar verschillende acties koppelen aan verschillende zekerheidsniveaus. Hoge zekerheid? Automatisch uitvoeren. Lagere zekerheid? Extra informatie vragen. Twijfel? Naar een medewerker sturen.
TypeSafe claimt extreem lage kosten
Het opvallendste onderdeel van de lancering zijn misschien de economische claims. TypeSafe rekent voor Jev 0,042 dollar per miljoen inputtokens, of 42 dollar per miljard tokens. Voor outputtokens rekent het bedrijf niets aan, omdat Jev geen tekst genereert zoals traditionele taalmodellen.
De startup claimt daarnaast responstijden tussen ongeveer 70 en 500 milliseconden en zegt dat Jev voor bepaalde gestructureerde beslissingen 40 tot 200 keer sneller kan zijn dan frontier-LLM’s met vergelijkbare prestaties. In de eigen workflowbenchmarks spreekt TypeSafe zelfs over maximaal 193,6 keer hogere snelheid en 444,6 keer lagere kosten.
Die cijfers vragen wel nuance. TypeSafe zegt zelf dat deze benchmarks waarschijnlijk aan de hoge kant van de realistische winst liggen. De evaluaties zijn bovendien opgesteld door medewerkers van het eigen model-capabilitysteam, waardoor een zekere bias niet kan worden uitgesloten.
Ook werden grote modellen als referentie gebruikt in plaats van volledig onafhankelijke menselijke ground truth. TypeSafe vergelijkt Jev onder meer met het gemiddelde oordeel van GPT-6 Astra en Claude Fable 5.1. Dat meet dus vooral hoe sterk Jev overeenkomt met andere krachtige modellen, niet automatisch hoe vaak een beslissing objectief correct is.
“Kan niet hallucineren” vraagt nuance
TypeSafe gebruikt een opvallende formulering: Jev zou niet kunnen hallucineren. Technisch heeft het bedrijf daar een punt, maar alleen binnen een heel specifieke betekenis. Omdat Jev uitsluitend uit vooraf toegestane waarden kan kiezen, kan het geen verzonnen tekst, niet-bestaande URL of willekeurig antwoord produceren buiten de vastgelegde structuur.
Een veld dat alleen `goedkeuren`, `weigeren` of `manuele controle` accepteert, zal nooit plots een paragraaf of een vierde categorie retourneren.Maar dat betekent niet dat Jev geen foute beslissing kan nemen.
Het model kan perfect `goedkeuren` kiezen terwijl `weigeren` eigenlijk correct was. Het verschil zit dus tussen een gegarandeerd correct formaat en een gegarandeerd correcte inhoudelijke beslissing.TypeSafe erkent dat zelf eveneens. Developers moeten het model op hun eigen data testen, confidence-drempels bepalen en inschatten wat de gevolgen van fouten zijn.
De slimme if-statement
De praktischste manier om Jev te begrijpen is misschien als een extreem slimme `if`-functie.
Klassieke software werkt goed wanneer regels exact vaststaan:
> Als bedrag groter is dan 1.000 euro, vraag goedkeuring.
Maar veel bedrijfsbeslissingen zijn moeilijk in vaste regels te vertalen:
> Lijkt deze klant op het punt te vertrekken?
> Bevat deze aanvraag tekenen van fraude?
> Is dit supportticket dringend?
> Is de output van deze AI-agent verdacht?
> Naar welke afdeling moet deze e-mail?
Voor dergelijke situaties worden nu vaak LLM’s gebruikt. Maar die zijn relatief duur, traag en gebouwd om vrij tekst te produceren. Jev probeert precies die “vage beslislogica” om te zetten in een gespecialiseerde AI-functie die developers direct tussen gewone softwarelogica kunnen plaatsen.
Waar Jev interessant kan worden
TypeSafe ziet toepassingen vooral op plekken waar enorme aantallen kleine beslissingen nodig zijn. Een klantenserviceplatform zou bijvoorbeeld elk binnenkomend bericht kunnen beoordelen op onderwerp, urgentie, sentiment en benodigde afdeling.
Een financiële toepassing kan transacties scoren op mogelijke fraude. Een salesplatform kan leads automatisch rangschikken. Een securitysysteem kan AI-prompts en outputs controleren op jailbreaks of verdachte patronen. En een AI-agent kan zijn werk na elke stap door Jev laten beoordelen voordat de volgende actie wordt uitgevoerd.
Dat laatste is bijzonder interessant. Generatieve AI-agents krijgen steeds meer autonomie, maar bedrijven willen tegelijk meer controle. Een goedkoop model dat continu als judge, verifier of guardrail optreedt, kan daardoor een heel andere rol krijgen dan een chatbot.
TypeSafe beschrijft Jev daarom niet als vervanger van LLM’s, maar als complementaire infrastructuur. Een generatief model kan bijvoorbeeld een antwoord schrijven, terwijl Jev bepaalt of het antwoord veilig genoeg is om te versturen.
Waarom snelheid hier belangrijker is dan bij chat
Bij een chatbot is een seconde extra vertraging vervelend, maar vaak acceptabel. In software is dat anders.
Wanneer een webshop, API, videogame, fraudedetectiesysteem of realtime applicatie bij iedere actie een AI-model moet raadplegen, kan enkele seconden latency het volledige product onbruikbaar maken. Een model dat in ongeveer honderd milliseconden een beslissing kan nemen, opent daarom toepassingen waarvoor grote generatieve modellen vandaag te traag of te duur zijn.
Dat is precies de gok die TypeSafe maakt: AI wordt niet alleen iets waarmee mensen praten, maar een onzichtbare beslislaag binnen bijna elk softwareproduct.
Van AI-assistent naar AI-infrastructuur
De visie van oprichter Diogo Almeida is opvallend omdat hij zelf meewerkte aan het onderzoek dat uiteindelijk leidde tot ChatGPT. Bij OpenAI hielp hij technieken ontwikkelen waarmee taalmodellen instructies beter konden volgen en natuurlijker met mensen konden communiceren. Maar volgens Almeida bleef één vraag knagen: als AI inmiddels zo goed kan converseren, waarom is nog zoveel software nauwelijks geautomatiseerd?
Zijn antwoord is dat chat misschien niet voor iedere vorm van intelligentie de juiste interface is. Voor mensen is vrije taal fantastisch. Voor software kan vrije taal juist een probleem zijn.
Programma’s willen weten of iets `true` of `false` is, welke categorie moet worden gekozen, hoe hoog een score ligt en hoe betrouwbaar die beslissin is.TypeSafe probeert daarom van AI een softwareprimitive te maken: iets dat developers kunnen gebruiken zoals een databasequery, API-call of gewone functie.
Een model dat bewust minder kan
Dat maakt Jev opvallend in een industrie waarin AI-bedrijven doorgaans proberen modellen steeds algemener te maken. Of dat genoeg is om een nieuwe categorie AI-modellen te creëren, moet nog blijken. Jev is op dit moment beschikbaar in early access, en de belangrijkste prestatieclaims komen voornamelijk van TypeSafe zelf. Onafhankelijke tests op grote productieworkloads zullen moeten aantonen hoe goed de kalibratie, latency en betrouwbaarheid overeind blijven wanneer duizenden bedrijven het systeem daadwerkelijk gebruiken.
Maar het idee achter Jev is interessant omdat het haaks staat op een groot deel van de huidige AI-race. De volgende grote stap in AI hoeft misschien niet altijd een model te zijn dat meer kan zeggen.
Het kan ook een model zijn dat veel sneller, goedkoper en voorspelbaarder één beslissing neemt, miljoenen keren per dag.