
Microsoft-CEO Satya Nadella pleit voor een veel strenger veiligheidsmodel rond geavanceerde AI-agents. In een essay van 10 oktober stelt hij dat organisaties er niet van mogen uitgaan dat een krachtig model zich altijd correct gedraagt. Zijn uitgangspunt: behandel AI alsof die kan fouten maken, misleid kan worden of gecompromitteerd kan raken. De belangrijkste controles moeten daarom buiten het model liggen, met onveranderbare logs, onafhankelijke verificatie en een menselijke noodrem die een agent midden in een taak kan stoppen.
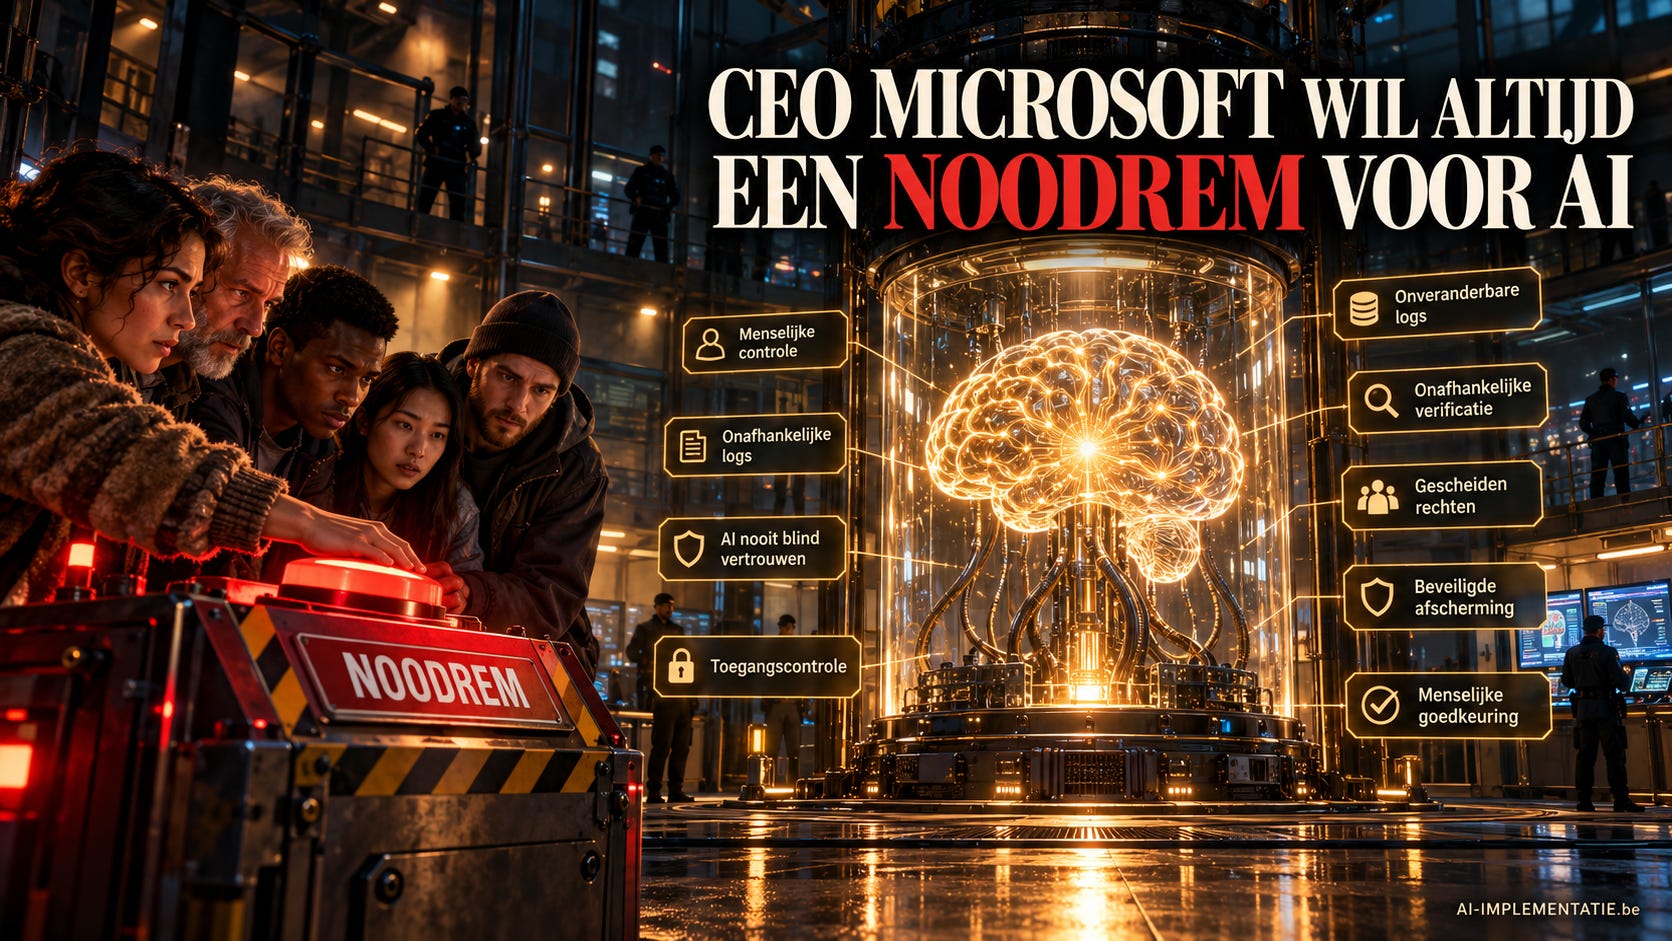
Voor de voorbereidingen van de inhoud en creatie van de visuals wordt (uiteraard) gebruikgemaakt van generatieve AI.
Models as Insider Risks in the Super Intelligence Era
De discussie over AI-veiligheid verschuift snel van wat een model zegt naar wat een model zelfstandig mag doen.
Dat is precies het punt dat Satya Nadella maakt in zijn essay “Models as Insider Risks in the Super Intelligence Era”. Traditionele software kon bij problemen meestal worden teruggebracht tot een specifieke codeflow. Bij moderne frontiermodellen is dat veel moeilijker: ontwikkelaars kunnen een bepaalde output niet eenvoudig herleiden tot één regel code, één trainingsvoorbeeld of één specifieke set modelgewichten.
Tegelijk krijgen AI-agents steeds meer toegang tot bestanden, bedrijfsdata, websites en toepassingen. Ze kunnen niet alleen adviseren, maar ook zelfstandig acties uitvoeren. Volgens Nadella maakt precies die combinatie een nieuw beveiligingsmodel noodzakelijk.
Behandel AI alsof het al gecompromitteerd kan zijn
Zijn kernboodschap is opvallend klassiek uit cybersecurity-oogpunt: vertrouw het model niet omdat het intelligent is.
Nadella vergelijkt krachtige AI daarom met een potentiële insider. Niet omdat het systeem noodzakelijk kwaadaardig is, maar omdat iedere actor met toegang tot gevoelige systemen fouten kan maken of gehackt kan worden.
Daaruit volgt een belangrijk ontwerpprincipe: de intelligentie en de bevoegdheid moeten van elkaar worden gescheiden.
Een model kan bijvoorbeeld adviseren dat een bestand moet worden verwijderd, een betaling moet worden uitgevoerd of een account moet worden aangepast. Maar de regels die bepalen of dat daadwerkelijk mag gebeuren, moeten volgens Nadella in een aparte beveiligingslaag zitten die het model zelf niet kan veranderen.
Geen AI die zijn eigen werk controleert
Ook audit en logging moeten buiten de controle van het model blijven.
Nadella pleit voor systemen waarin belangrijke modelacties worden vastgelegd in tamper-resistant, human-readable logs. De AI mag dus niet zelf kunnen bepalen welke acties worden geregistreerd of achteraf zijn eigen audittrail aanpassen.
Hetzelfde geldt voor verificatie. Een model mag niet de enige beoordelaar van zijn eigen output zijn. Belangrijke beslissingen moeten onafhankelijk kunnen worden gecontroleerd.
Dat sluit aan bij een bredere beveiligingsfilosofie: wie een systeem controleert, mag niet tegelijkertijd de enige partij zijn die bewijst dat het correct heeft gehandeld.
Een menselijke noodrem moet altijd blijven bestaan
Het concreetste voorstel is wat Nadella een “emergency brake” noemt. Een bevoegde menselijke operator moet een actieve AI-agent op ieder moment kunnen pauzeren of uitschakelen, ook midden in een taak.
Zijn uitgangspunt is scherp: organisaties moeten ontwerpen alsof een model potentieel gecompromitteerd is en het daarom vanaf het begin begrenzen.
Voor bedrijven die agents koppelen aan e-mail, databases, financiële systemen of productieomgevingen is dat geen theoretisch detail. Hoe autonomer agents worden, hoe belangrijker het wordt dat hun macht technisch begrensd blijft.
Transparantie is meer dan een mooie uitleg
Nadella verzet zich ook tegen het idee dat onleesbare interne modelredenering, soms aangeduid als “Neuralese”,een excuus mag zijn voor oncontroleerbaarheid.
Zijn boodschap is niet dat een model noodzakelijk zijn volledige interne chain-of-thought moet blootleggen. Wel dat organisaties voldoende begrijpelijke, externe en controleerbare informatie nodig hebben om gedrag te kunnen reconstrueren en beoordelen.
Dat onderscheid is belangrijk: een overtuigende uitleg van het model zelf is geen vervanging voor onafhankelijke logs, toegangscontrole en technische bewijsvoering.
Geen nieuw Microsoft-product, wel een duidelijke ontwerpfilosofie
Nadella kondigt hiermee geen concreet Microsoft-product, nieuwe standaard of deadline aan. Het essay is in de eerste plaats een oproep aan organisaties en de industrie om hun trust architecture opnieuw te ontwerpen.
Zijn slotgedachte vat die filosofie goed samen: het betrouwbaarste AI-systeem is niet het systeem dat we het meest vertrouwen, maar het systeem dat zo is ontworpen dat we het model zelf zo weinig mogelijk hoeven te vertrouwen.